Microsoft 365 zu 364 – ein Ausfall ohne Hacker und ohne KI
Der Microsoft 365 Ausfall vom 12. November 2026 legte Postfächer in aller Welt lahm und dauerte bis zur vollständigen Wiederherstellung rund anderthalb Tage. Hacker oder KI waren laut Microsoft nicht schuld, und ich erkläre dir mit einem Postamt, was technisch dahintersteckt.
(Lesedauer: ca. 20 Minuten)
Freitagmorgen auf Arbeit, Rechner an. Outlook startet wie jeden Tag aus dem Autostart und legt mir statt des Posteingangs eine Fehlermeldung auf den Bildschirm. Es folgt das Programm, das jeder kennt, der schon einmal vor einem streikenden Rechner saß: hektisches Probieren, Neustart, Netzwerk prüfen. Der Browser kommt ins Internet, am Kabel liegt es also nicht. Dann eben Outlook im Browser: geht auch nicht. Mhh. Und jetzt?
Im Hintergrund dudelt das Radio, dann kommen die Nachrichten: Microsoft hat Probleme, Outlook ist für Tausende Nutzer nicht erreichbar. Ich hatte also nicht meinen Rechner kaputtgeklickt, ich war einer von sehr vielen. Das schafft Freizeit in der Arbeitszeit, könnte man meinen. Leider nicht, es gibt ja noch genug andere Dinge zu tun. Hängen geblieben ist trotzdem ein Gedanke: Der Name Microsoft 365 klingt nach einem Dienst, der an allen 365 Tagen im Jahr läuft. In diesem Jahr ist es eher Microsoft 364.
Angefangen hatte das Ganze schon am Donnerstag, dem 12. November 2026. Über 25 Stunden vergingen bis zur Entschuldigung, rund anderthalb Tage bis zur vollständigen Wiederherstellung. Störungsmeldungen kamen aus 74 Ländern und Gebieten, und IT-Abteilungen weltweit lernten, wie sich das Wort „Klumpenrisiko“ (alles hängt an einem Anbieter) in der Praxis anfühlt.
Ich habe mir die bisherigen Statusmeldungen von Microsoft angesehen und versucht zu verstehen, was da eigentlich passiert ist. Wir gehen zuerst die Chronologie durch, schauen uns dann an, wie die Cloud hinter Outlook aufgebaut ist, und danach, wie ausgerechnet Microsofts eigene Schutzmechanismen die Lage verschlimmert haben. Zum Schluss trennen wir Bestätigtes von den Gerüchten über Hacker, rebellierende KI-Agenten und angebliche Rekordschäden und klären, was du für dich mitnehmen kannst.
1. Einleitung
Große Cloud-Ausfälle beflügeln die Fantasie. Bleiben Millionen Bildschirme gleichzeitig leer, vermutet das Internet wahlweise staatliche Hacker, ein durchgebranntes Rechenzentrum oder eine künstliche Intelligenz, die sich selbst den Stecker gezogen hat. Die Wirklichkeit dieses Novembers war profaner, und gerade deshalb lohnt der genaue Blick.
1.1. Der Startschuss am Donnerstagabend
Am 12. November 2026 um 17:17 Uhr ging in Deutschland der Arbeitstag zu Ende, in New York war es kurz nach elf Uhr am Vormittag. In dieser Minute begannen laut Microsoft die ersten Fehler beim Zugriff auf Postfächer. Betroffen war im Kern Exchange Online, Microsofts E-Mail-Dienst in der Cloud. Outlook ist streng genommen nur das Programm, mit dem man in dieses Postfach hineinschaut. Genau deshalb konnte mein Neustart am Freitag nichts ausrichten: Das Programm war in Ordnung, nur das Postfach dahinter nicht erreichbar. Erst waren es wenige Betroffene, dann Tausende, und binnen etwa einer Stunde hatte Downdetector Meldungen aus 74 Ländern und Gebieten erfasst.
Mehr als 25 Stunden vergingen, bis sich Microsoft öffentlich entschuldigte und eine Ursache nannte. Rund anderthalb Tage dauerte es, bis der Konzern am Samstag meldete, die Arbeit am zugrunde liegenden Problem sei abgeschlossen und der Dienst für die restlichen Kunden und Regionen wiederhergestellt. Für einen Konzern, der Unternehmen, Behörden und Krankenhäuser in seine Cloud bittet und dabei gern Verlässlichkeit verspricht, ist das selbst bei großzügiger Rechnung eine Ewigkeit. Die Entschuldigung selbst fiel übrigens denkbar knapp aus, dazu später mehr.
1.2. Das eigentliche Mysterium im Hintergrund
Verblüffend an diesem Ausfall ist, was nicht passiert ist. Nach allem, was Microsoft mitgeteilt hat, gab es keinen Hackerangriff (Abschnitt 5.2). Es drängten auch nicht mehr Nutzer als an einem gewöhnlichen Donnerstag auf die Systeme (Zeitstrahl in 2.1). Und die Hardware war nicht kaputt, aber viele Server waren nicht mehr erreichbar oder reagierten nicht (Abschnitt 3.1).
An diesem scheinbaren Widerspruch scheitern die üblichen Stammtischerklärungen. Wenn weder Eindringlinge noch ein Besucheransturm noch abgerauchte Hardware schuld sind, muss das Problem in der Mechanik liegen, die Anfragen durch Microsofts Netze schleust. Bevor wir die auseinandernehmen, schauen wir auf die nackten Uhrzeiten.
2. Chronologie des Ausfalls

Die öffentliche Kommunikation bei großen Cloud-Vorfällen folgt einem vertrauten Drehbuch: Am Anfang steht das beruhigende „Wir schauen mal“, irgendwann folgen kryptische Hinweise auf fehlende Kapazität, und spät in der Nacht schimmert durch, dass die ersten Rettungsversuche verpufft sind. Wir gehen den Zeitstrahl durch, alle Angaben in deutscher Zeit: den Donnerstagabend, die Nacht, die Folgen am Freitagmorgen und die Erholung bis Samstag.
2.1. Donnerstagabend: Die Störung breitet sich aus
Am frühen Abend klemmte nur der Postfachzugriff. Innerhalb von gut zwei Stunden griff die Störung auf zentrale Dienste für Zusammenarbeit und Sicherheit über, und Microsoft zog bei den eigenen Systemänderungen die Notbremse.
| Uhrzeit (dt. Zeit) | Ereignis / Statusmeldung von Microsoft | Einordnung |
|---|---|---|
| Do, 17:17 Uhr | Erste Fehler beim Zugriff auf Postfächer in Exchange Online; kurz darauf folgt der Hinweis „Wir untersuchen das“. | Beginn des Vorfalls am Ende des europäischen Arbeitstags und am späten US-Vormittag. |
| Do, ca. 19:00 Uhr | Die Störungsplattform Downdetector verzeichnet in der Spitze rund 130.000 Meldungen zu Outlook. | Wichtiger Hinweis: Das sind gemeldete Störungen, keine direkte Zählung einzelner Nutzer. |
| Do, 19:26 Uhr | Microsoft eröffnet einen zweiten, breiteren Vorfall. Betroffen sind nun auch Teams (Besprechungen und Chats), SharePoint (Dateien), Copilot (KI-Assistent) und die Sicherheitsportale. | Aus der ursprünglichen Eingrenzung „Nutzer in Amerika“ wird „Nutzer in jeder Region“. |
| Do, kurz nach 20:00 Uhr | Microsoft stoppt sämtliche eigenen Änderungen am System. | Klassischer Krisenreflex: Nichts mehr anfassen, bis man weiß, was brennt. |
| Do, 20:18 Uhr | Erster technischer Fingerzeig: Die hohe Last resultiert nicht aus mehr Datenverkehr, sondern aus fehlenden Servern. | Der Verkehr ist normal, nur stehen plötzlich viel zu wenige Maschinen zur Verfügung. |
| Do, 20:43 Uhr | Betroffene Server bestehen den automatischen Health Check (siehe 4.1) nicht und werden aus dem Dienst genommen; Verdacht auf ein bestimmtes Bauteil hinter den fehlgeschlagenen Prüfungen. | Die interne Aufsicht schaltet reihenweise Systeme ab. |
| Do, 21:56 Uhr | Eine geänderte Methode für den Health Check hilft, einige Server vorübergehend zurückzuholen. | Erster kleiner Teilerfolg, der das Grundproblem aber noch nicht löst. |
| Do, ca. 23:00 Uhr | Eingeständnis, dass die bisherigen Maßnahmen nicht die erhoffte Entlastung bringen; ein zentraler Prozess auf den Servern wird überlastet. | Spätestens jetzt ist klar: Das wird keine kurze Nachtschicht. |
Die feine Ironie liegt zwischen 20:00 Uhr und dem späteren Verlauf der Nacht: Am Donnerstagabend fand Microsoft offenbar keine eigene Änderung, die zeitlich zum Ausbruch passte, und fror vorsorglich alle laufenden Arbeiten ein. Das System verlor trotzdem munter weiter Kapazität.
2.2. Die Nacht der Rückschläge
Was die Nacht auf Freitag für Microsofts Betriebsteams so zermürbend machte, zeigte sich um 1:00 Uhr. Zurückgeholte Server blieben nicht im Dienst, sondern fielen sofort wieder aus, sobald sie Arbeit bekamen. Man stelle sich den Leitstand vor: Eine Maschine geht zurück ins Rennen, für einen Moment leuchtet alles grün, und beim ersten echten Kundenkontakt klappt sie wieder zusammen. Um 2:06 Uhr benannte Microsoft den überlasteten Prozess: Es war der Teil, der die sicheren Verbindungen aufbaut. Im selben Update kündigte der Konzern an, eine kürzliche Netzwerk-Konfigurationsänderung zurückzunehmen, die zum Beginn des Vorfalls passte. Im Fachjargon heißt das Rollback.
Bemerkenswert ist diese Kurskorrektur, weil am Donnerstagabend noch kein zeitlicher Zusammenhang gesehen worden war. Wer schon einmal mitten in der Nacht eine Konfigurationsänderung rückgängig gemacht hat, während die Alarme schrillen, kennt das leicht verzweifelte Stoßgebet Richtung Serverschrank. Es half zunächst nicht: Um 4:07 Uhr kam die Rückmeldung, die Änderung greife nicht wie erwartet, man suche andere Wege zu mehr Kapazität. Kurz vor 8:00 Uhr meldete Microsoft lediglich einen geringen Erfolg. Um 8:29 Uhr zeichnete sich dann die Wende ab: Nach einem Patch an einer vorgelagerten Komponente für Authentifizierung und Routing besserte sich die Stabilität zumindest bei einem Teil der Server.
2.3. Folgen: zurück zum Telefon
Während in den Rechenzentren noch um Stabilität gerungen wurde, brach in Europa der Freitagmorgen an, und mit ihm kamen die Folgen einer Welt, die sich auf einen einzigen Anbieter für Büro-Software verlässt. Was nach einem E-Mail-Problem klingt, schlug binnen Stunden in Bereiche durch, in denen mehr auf dem Spiel steht als ein Newsletter:
- Gesundheitswesen in Großbritannien: Einzelne NHS-Einrichtungen verschoben laut BBC Termine, darunter Kaiserschnitte. Andere arbeiteten trotz ausgefallener E-Mail normal weiter, im King’s College Hospital liefen geplante Eingriffe wie vorgesehen.
- Strafverfolgung in Großbritannien: Die Londoner Metropolitan Police konnte zeitweise keine Online-Anzeigen entgegennehmen, Notrufe liefen weiter.
- Luftfahrt in Indien: Bei den Fluggesellschaften Air India und IndiGo lief der Flugbetrieb nach eigenen Angaben normal. IndiGo meldete Störungen im E-Mail-Kundenservice, Air India leitete seine E-Mails vorübergehend um.
- Regierungsarbeit in Japan: Laut der Regierung sicherten die Behörden alternative Kommunikationswege, etwa Telefone.
Dass Regierungen im Jahr 2026 wieder zum Telefonhörer greifen, weil ein Cloud-Konzern seine Netzwerkkonfiguration verhaspelt hat, hat etwas Tragikomisches. Bei mir lief es ähnlich altmodisch: Erfahren habe ich vom Ausfall nicht aus dem Postfach, sondern aus dem Radio. Man fragt sich unwillkürlich, wie viele Krisensitzungen an diesem Morgen daran scheiterten, dass die Telefonnummer des zuständigen Ansprechpartners brav im unerreichbaren Postfach lag.
2.4. Erholung am Freitag und Samstag

Um 10:10 Uhr verlängerte Microsoft die Frist für wartende E-Mails auf 48 Stunden (Hintergrund in Abschnitt 4.3); die Kapazität war laut Microsoft noch nicht wieder normal. Gegen Mittag kamen Fortschrittsmeldungen aus allen Regionen, aus Teilen Asiens, Europas und Nordamerikas, und um 15:00 Uhr waren die aufgestauten Warteschlangen für E-Mails deutlich kürzer.
Um 18:57 Uhr, mehr als 25 Stunden nach den ersten Störungsmeldungen, entschuldigte sich Microsoft offiziell und nannte erstmals eine Ursache, verpackt in genau einen Satz (Abschnitt 5.1). Um 21:02 Uhr hieß es ergänzend, Anmeldung und Zugriff funktionierten wieder besser. Einen Termin für die vollständige Erholung gab es nicht. Erst am Samstag, dem 14. November, meldete Microsoft auf X, die Arbeit am zugrunde liegenden Problem sei abgeschlossen und der Dienst für die restlichen Kunden und Regionen wiederhergestellt (Stand: 14. November 2026). Vom Beginn am Donnerstag um 17:17 Uhr gerechnet, dauerte der Ausfall damit rund anderthalb Tage. Aus Microsoft 365 war für dieses Jahr also Microsoft 364 geworden, genau genommen eher 363 und ein halbes. Den Witz hatte The Register schon im Januar: Nach einem knapp zehnstündigen Ausfall stand dort „Down to 364.5 already“.
3. Was „down“ in der Cloud bedeutet
Warum bremst ein einzelner Engpass Outlook und den KI-Assistenten Copilot aus, während Telefonate über Teams weiterliefen? Dafür müssen wir uns von der Vorstellung einzelner, sauber getrennter Programme verabschieden. Wir schauen erst auf das Gesamtgebilde und dann auf den Weg, den eine einzelne Anfrage nimmt.
3.1. Das vernetzte Postamt Microsoft 365
Microsoft 365 ist kein einzelnes Programm, sondern ein Bündel aus Diensten, die in Rechenzentren rund um den Globus laufen: Outlook für E-Mails, Teams für Besprechungen und Chats, SharePoint für Dateien und Copilot als KI-Assistent. Microsoft beschreibt diese Dienste selbst als voneinander abhängig und tief miteinander verzahnt. Solange alles läuft, ist das ein schöner Werbesatz. Sobald ein Teil hakt, ist es eine ziemlich ungemütliche Architekturbeschreibung.
Stell dir Microsoft 365 als riesiges Postamt vor. Ganz hinten im Gebäude liegt das zentrale Lager, in Microsofts Welt ist das Exchange Online. Dort lagern E-Mails, aber ebenso Kalender und Kontakte. Damit löst sich das Rätsel, warum während des Ausfalls ganz unterschiedliche Funktionen gleichzeitig streikten und andere unbeeindruckt weiterliefen:
- Teams braucht das Lager für Termine: Wer ein Meeting ansetzen oder Einladungen verschicken will, muss auf den Kalender in Exchange Online zugreifen. Weil das Lager nicht erreichbar war, scheiterte die Terminplanung. Reine Anrufe und Chats in Teams liefen dagegen größtenteils weiter, weil sie diesen Umweg nicht brauchen.
- Copilot fehlt der Lesestoff: Ein KI-Assistent, der Fragen zu laufenden Vorgängen beantworten soll, muss auf E-Mails, Termine und Dateien zugreifen können. Ohne Zugang zum Lager steht auch der vielgepriesene Assistent höflich achselzuckend im Flur.
- Weitere Verbunddienste geraten ins Stocken: Spätestens mit dem zweiten Vorfall um 19:26 Uhr zeigte sich an SharePoint und den Sicherheitsportalen, wie stark die ganze Suite an derselben Infrastruktur hängt.
Es war also keineswegs alles weg. Weg war alles, was durch die Tür zum zentralen Lager musste. Das Bild räumt auch mit einem beliebten Missverständnis über das Wort „down“ auf. Im Alltag meint man damit abgeschaltete oder defekte Computer. Hier war das Postamt hell erleuchtet, das Lager bis unter die Decke gefüllt, und die Hardware war nicht kaputt. Aber viele Schalter reagierten nicht mehr, und die Schlange vor dem Haus kam kaum noch bis zum Schalter durch. „Down“ heißt in der Cloud fast nie „kaputt“, sondern meist „nicht erreichbar“.
3.2. Vier Stationen bis zur E-Mail
Wenn du am Laptop auf Outlook klickst, wirkt das wie ein einziger Augenblick, jedenfalls an Tagen, an denen du nicht alle fünf Sekunden ungeduldig neu lädst. Technisch legt jede Anfrage dabei vier Stationen bis zum Postfach zurück, und jede davon spielt beim Ausfall eine Rolle:
- Station 1, Telefonbuch und Eingangstür (DNS und Front Doors): Dein Gerät kennt zunächst nur einen lesbaren Namen, keine Netzwerkadresse. Deshalb fragt es das DNS, das Telefonbuch des Internets, welche Nummer zu diesem Namen gehört. Die Antwort schickt die Anfrage nicht um den halben Erdball, sondern zum nächstgelegenen Eingang in Microsofts eigenes Netz. Microsoft nennt diese Zugangspunkte Front Doors, Eingangstüren, von denen es Hunderte Standorte weltweit gibt.
- Station 2, die rechenintensive Ausweiskontrolle (TLS-Handshake): Bevor auch nur ein Wort einer E-Mail übertragen wird, bauen Gerät und Server eine verschlüsselte Verbindung über das Verfahren TLS auf. Der Server zeigt sein Zertifikat vor, gewissermaßen seinen Dienstausweis, und beide Seiten handeln einen geheimen Sitzungsschlüssel aus. Dieser Auftakt heißt TLS-Handshake (Handschlag). Für alles Weitere wichtig: Der Handschlag kostet deutlich mehr Rechenarbeit als das spätere Übertragen der eigentlichen Daten. Deshalb halten Programme eine einmal aufgebaute Verbindung möglichst lange offen, und der Ausweis wird im Normalbetrieb nicht bei jedem Brief neu kontrolliert.
- Station 3, der Einweiser in der Halle (Lastverteiler, Load Balancer): Hinter der Eingangstür wartet kein einzelner Supercomputer, sondern eine ganze Menge Server, die alle dieselbe Arbeit erledigen können. Ein Lastverteiler spielt den Einweiser am Halleneingang und entscheidet in Echtzeit, welcher freie Schalter die nächste Anfrage übernimmt („Schalter 7 ist frei“).
- Station 4, Schalter und vierfach gesichertes Lager (Front-End-Server und Datenbanken): Die Server direkt hinter dem Einweiser heißen Front-End-Server. Sie sind die Schalterbeamten des Postamts: Sie speichern selbst keine E-Mail dauerhaft, sondern nehmen die Anfrage entgegen und holen die Daten aus dem Lager im Hintergrund. Dort spart Microsoft nicht an Vorsicht: Laut eigener Dokumentation gibt es von jeder Postfach-Datenbank vier Kopien, verteilt über mehrere Rechenzentren.

Nach allem, was Microsoft bisher mitgeteilt hat, lag das Problem nicht im Lager. Die vierfach kopierten Datenbanken blieben intakt. Der Ärger spielte sich auf dem Weg dorthin ab, irgendwo zwischen Eingangstür, Ausweiskontrolle, Einweiser und Schalter.
4. Die technische Kettenreaktion

Dass in einem Netz mit Abertausenden Servern jeden Tag irgendwo eine Maschine streikt, ist kein Skandal, sondern Alltag, und große Cloud-Plattformen sind dafür gebaut, das geräuschlos wegzustecken. Ausgerechnet diese Automatik hat den Ausfall auf mehr als einen Tag gestreckt. Wir schauen uns an, wie die Aufsicht Schalter schließt, warum frisch geöffnete Schalter sofort überrannt werden und wie Microsoft die Spirale schließlich gebremst hat.
4.1. Health Checks und Failover am Anschlag
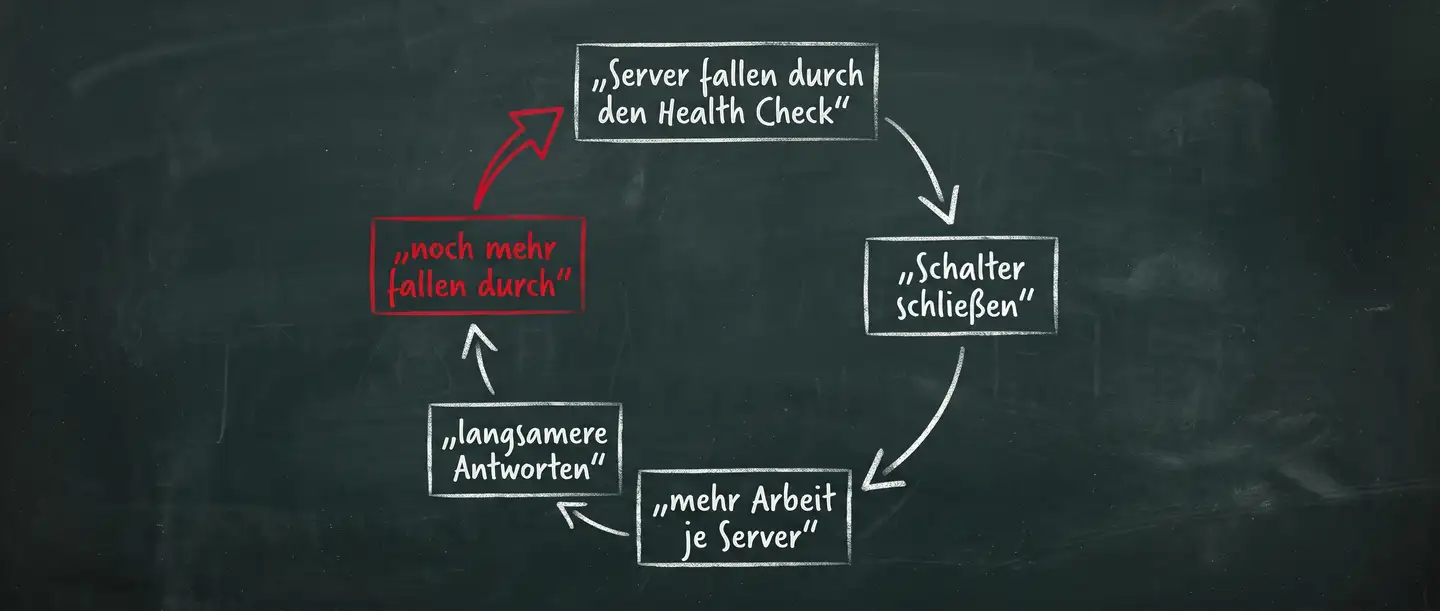
Damit der Einweiser niemanden an einen abgestürzten Schalter schickt, prüft der Lastverteiler seine Server in festem Takt mit Health Checks. Das Prinzip ist simpel: „Bist du da? Antwortest du rechtzeitig?“ Wie eng das getaktet sein kann, zeigt als Beispiel die Dokumentation eines anderen Microsoft-Dienstes: Bei Azure Front Door findet der Health Check in der Grundeinstellung alle 30 Sekunden statt. Kommt „alles in Ordnung“ zurück, bleibt der Server im Dienst. Jede andere Antwort und auch schlichtes Schweigen zählen als Fehler. Im Postamt geht die Aufsicht die Schalter ab: Wer nicht reagiert, bekommt sofort das Schild „geschlossen“, und der Einweiser schickt alle Kunden zu den übrigen Schaltern.
Dieses automatische Umschalten heißt Failover. Im Normalbetrieb sind mehr Schalter geöffnet, als die Schlange eigentlich braucht, und von alltäglichen Defekten merkst du nichts. Das beruht allerdings auf einer stillen Annahme: Es fallen immer nur wenige Server gleichzeitig durch den Health Check.
Am Donnerstagabend bröckelte genau diese Annahme (Zeitstrahl in 2.1): Unerwartet viele Server fielen gleichzeitig durch den Health Check. Kurz darauf deutete Microsoft an, die fehlgeschlagenen Prüfungen könnten von einem bestimmten Bauteil ausgehen, im Postamt-Bild also nicht von den Schaltern selbst, sondern von der Aufsicht, die die Schilder aufhängt. Ab da schließt das System pflichtbewusst sehr viele Schalter auf einmal, und die ganz normale Donnerstagsschlange staut sich vor den wenigen übrigen. Damit beginnt die Spirale, die Fachleute Kaskade nennen: Weniger offene Schalter bedeuten mehr Arbeit für jeden verbliebenen Server. Überlastete Server reagieren träger und antworten langsamer. Wer zu langsam antwortet, fällt bei der nächsten Prüfung ebenfalls durch und wird abgeschaltet. Das System schützt sich buchstäblich zu Tode, indem es aus purer Fürsorge immer mehr Kapazität aus dem Rennen nimmt.
4.2. TLS-Handshake und Neuversuche
Microsoft spricht nur von einem überlasteten Prozess für sichere Verbindungen, das Wort TLS fällt in den Statusmeldungen nicht. Wie die Teile genau zusammenhängen, ist deshalb meine Deutung, bis der Post-Incident-Report vorliegt. Die Kaskade allein erklärt nämlich nicht, warum frisch gestartete oder zurückgeholte Server (Abschnitt 2.2) bei Arbeitsbeginn sofort wieder wegknickten. Den Schlüssel vermute ich bei Station 2, der Ausweiskontrolle per TLS-Handshake.
Im Normalbetrieb halten Millionen Endgeräte ihre einmal aufgebaute TLS-Verbindung einfach offen. Der teure Handschlag (Station 2 in 3.2) ist längst erledigt, es fließen nur noch vergleichsweise günstige Nutzdaten. Fällt ein Server aus oder nimmt ihn der Health Check aus dem Dienst, verlieren alle verbundenen Geräte auf einen Schlag ihre Leitung. Und was macht Software, wenn eine Verbindung abreißt? Sie startet sofort einen automatischen Neuversuch (Retry).
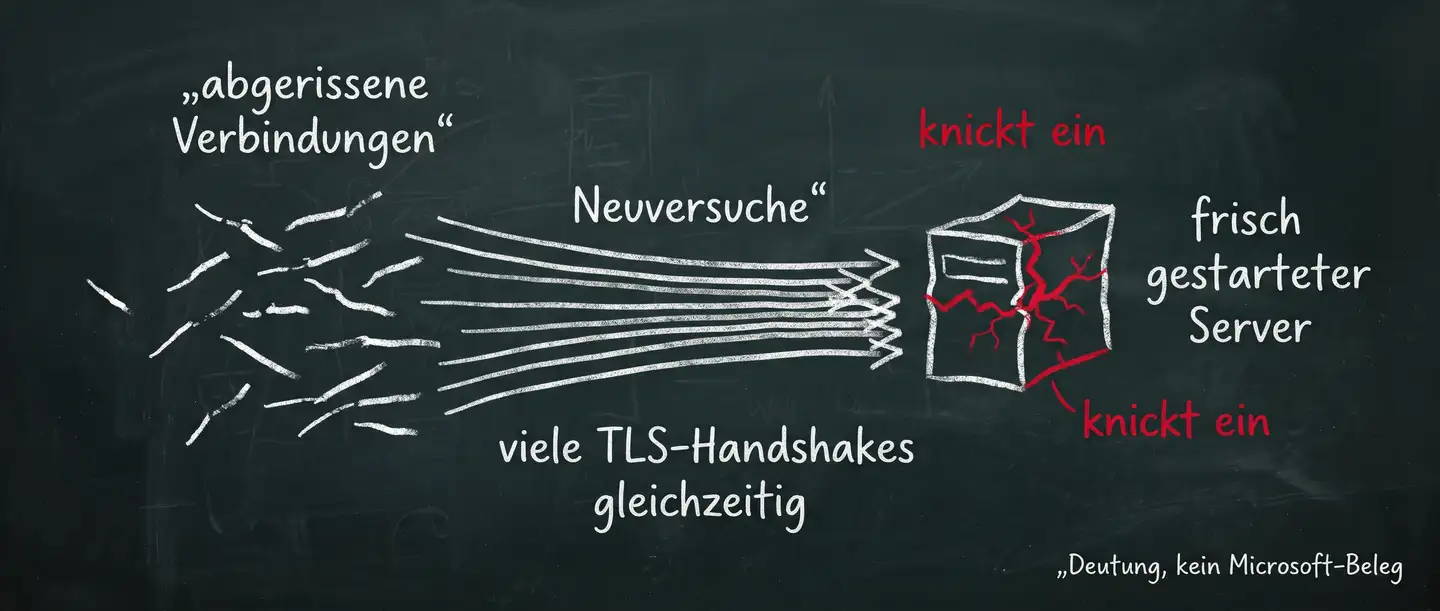
Für einen frisch gestarteten oder gerade wieder zugeschalteten Server ist das der denkbar schlechteste Empfang. Er bekommt keine gewöhnliche Arbeit, sondern eine geballte Welle aus lauter neuen TLS-Handshakes. Im Postamt: Kaum zieht ein Schalter die Jalousie hoch, rennt die ganze wartende Halle gleichzeitig hin, jeder mit dem Ausweis in der Hand und dem Wunsch nach einer kompletten Sicherheitsprüfung. Eine Minute später klappt der Schalter wieder zu, nicht weil die Hardware defekt wäre, sondern weil ihn die Rechenlast der gleichzeitigen Ausweiskontrollen überrennt. Das passt zu Microsofts nächtlicher Diagnose (Abschnitt 2.2 und Zeitstrahl in 2.1), wonach der Prozess für den Aufbau sicherer Verbindungen unter der Last zusammenbrach. Ebenso passt, dass Microsoft um 5:57 Uhr einen sprunghaften Anstieg der Aufrufe von Routing-Diensten an Backend-Server meldete. Mein eigener Neustart am Freitagmorgen war übrigens auch so ein Neuversuch. Ein winziger Tropfen in der Welle, aber ich war dabei.
4.3. Notbremsung und geduldige E-Mails
Aus diesem Teufelskreis kommt man nicht heraus, indem man optimistisch den Einschaltknopf drückt. Solange die ganze Schlange über jeden frischen Server herfällt, verpufft jeder Neustart. Microsoft musste tun, was für Wartende widersinnig klingt: weniger Leute hereinlassen, damit überhaupt wieder jemand bedient wird.
Der Konzern griff zu drei mechanischen Bremsen. An einigen Standorten wurden bestimmte Arten von Datenverkehr gezielt begrenzt. Zurückkehrende Server wurden abgeschirmt hochgefahren, damit sie nicht sofort im Sturm der Neuversuche untergingen. Und gleichzeitig kam zusätzliche Kapazität hinzu. Bis diese Mischung aus Drosselung, Abschirmung, zusätzlicher Kapazität und Patches griff, dauerte es bis zum Freitagmorgen (erste Besserung um 8:29 Uhr), und auch um 10:10 Uhr war die Kapazität noch nicht wieder normal. So zäh sind solche Rückkopplungsschleifen.
Vor dauerhaftem Datenverlust bewahrte viele Unternehmen eine Eigenheit, die man leicht unterschätzt: E-Mail ist von Grund auf geduldig gebaut. Kann ein Mailserver eine Nachricht nicht zustellen, wirft er sie nicht weg, sondern legt sie in eine Warteschlange (Queue) und versucht es später erneut. Erst nach einer festen Frist gibt er auf und schickt die Mail als unzustellbar an den Absender zurück. Laut Microsofts Dokumentation liegt diese Frist bei 24 Stunden. Weil die Störung am Freitagvormittag gefährlich nahe an diese Marke heranrückte, verlängerte Microsoft am Freitag um 10:10 Uhr die Frist der Warteschlange auf 48 Stunden. Die Nachrichten kamen also verspätet an, statt zu verfallen. Von verlorenen Postfächern hat Microsoft nichts berichtet. Draußen im Netz lief derweil längst die Suche nach den Schuldigen.
5. Ursachen: bestätigt und offen
Sobald ein großer Cloud-Anbieter länger als ein paar Stunden schweigt oder nur vage Statusmeldungen absetzt, füllt das Internet die Lücke mit erstaunlicher Kreativität. Wir trennen deshalb, was Microsoft tatsächlich zu Protokoll gegeben hat, was frühe Berichte andeuten und was ins Reich der Spekulation gehört.
5.1. Microsofts Ein-Satz-Erklärung
Am Freitagabend um 18:57 Uhr lieferte Microsoft zusammen mit der Entschuldigung die erste offizielle Ursache, in einem einzigen Satz. Übersetzt lautet er:
Der Vorfall entstand durch ein Problem bei einem früheren Ausbau der Netzwerkkapazität, das nach einer kürzlichen Netzwerk-Änderung zutage trat.
Das beschreibt eine Zeitbombe mit zwei Stufen. Erst baut Microsoft zu einem früheren Zeitpunkt die Kapazität seines Netzes aus, und dabei entsteht ein Fehler, der zunächst folgenlos bleibt. Später bringt eine neue Änderung am Netz genau diesen schlummernden Fehler zum Vorschein. Das passt gut zur Nacht auf Freitag (Abschnitt 2.2): Zunächst fand Microsoft keine Änderung, die zeitlich zum Beginn passte, begann dann aber doch, eine Netzwerk-Konfigurationsänderung zurückzunehmen, und brauchte danach noch weitere Patches.
Außerdem betonte Microsoft, es sei ein technisches Problem gewesen. Zu Cyberangriff und KI mehr in Abschnitt 5.2.
5.2. Vier populäre Theorien im Realitätscheck
Binnen Stunden machten vier Erklärungen die Runde. Die Tabelle zeigt, worauf sie sich stützen und wo Belege oder technische Parallelen fehlen.
| Theorie / Behauptung | Offizieller Stand & Beleglage | Technische Einordnung |
|---|---|---|
| 1. Hackerangriff / Cyberattacke | Von Microsoft mehrfach ausdrücklich verneint (u. a. in der Nacht auf Freitag); es gebe keinen Hinweis auf böswillige Aktivität. | Keine einzige belegte Angabe widerspricht bisher Microsofts Dementi. |
| 2. Durchgedrehte KI oder KI-Agenten | Von Microsoft ausdrücklich verneint; wer die Vermutung zuerst aufgebracht hat, lässt sich nicht belegen. | Keinerlei Belege vorhanden; Copilot war vielmehr Opfer, weil ihm schlicht die Postfachdaten fehlten. |
| 3. „Genau wie CrowdStrike 2024“ | Kam in Australien auf: Innenminister Tony Burke sagte nach einem Gespräch mit Jane Livesey, der Präsidentin von Microsoft Australien und Neuseeland, es handle sich offenbar um ein schiefgelaufenes Update, ähnlich wie bei CrowdStrike (AP). | Beim Ausmaß mag der Vergleich passen, technisch hinkt er gewaltig: 2024 legte ein fehlerhaftes Update einer Sicherheitssoftware Windows-Rechner bei Kunden vor Ort lahm; 2026 lag das Problem in Microsofts eigener Cloud, die Endgeräte der Nutzer waren völlig in Ordnung. |
| 4. Fehlerhaftes Update | Halb richtig, halb offen. Minister Burke sprach von einem Update. Microsoft selbst nennt in seiner Ein-Satz-Erklärung einen Netzausbau und eine Netzwerk-Änderung und nahm laut Statusmeldung selbst eine Netzwerk-Konfigurationsänderung zurück. | Eine Konfigurationsänderung im Netz als Auslöser passt zu Microsofts eigenem Rollback (Abschnitt 2.2). Um welche Änderung es genau ging, hat Microsoft bislang nicht veröffentlicht. |
Auch bei den gern zitierten Superlativen zur Größe des Ausfalls lohnt der genaue Blick. Die rund 130.000 Downdetector-Meldungen (Zeitstrahl in 2.1) sind Störungsmeldungen, keine 130.000 betroffenen Menschen. Wie viele Nutzer tatsächlich vor verschlossenen Postfächern saßen, weiß nur Microsoft. Ebenso kursieren Schätzungen über Schäden bis in den Milliardenbereich; CNN berichtete von einer Schätzung, wonach die Kosten 7 Milliarden US-Dollar übersteigen könnten. Mehr als eine Schätzung ohne belastbare Gesamtabrechnung ist das vorerst nicht.
5.3. Das Warten auf den Post-Incident-Report
Bei aller Klarheit über die vier Stationen des Postamts bleibt ein Rest im Nebel, und den benenne ich lieber ehrlich, als mit Fachbegriffen zu raten. Microsoft hat bisher nicht veröffentlicht, welcher Netzausbau gemeint war, wann er stattfand, worin der ursprüngliche Fehler bestand und welche kürzliche Netzwerk-Änderung ihn auslöste. Vor allem fehlt das Puzzleteil dazwischen: Wie wird aus einem Fehler tief im Netz am Ende ein überlasteter Prozess für sichere Verbindungen auf den Servern?
Die Antworten soll der angekündigte Post-Incident-Report liefern, der offizielle Abschlussbericht nach einer Störung. Ein Veröffentlichungsdatum nannte Microsoft bisher nicht (Stand: 15. November 2026), aber die eigene Dienstbeschreibung gibt den üblichen Takt vor: Bei Vorfällen mit großer Wirkung erscheint ein vorläufiger Bericht binnen 48 Stunden nach dem Ende, der endgültige Bericht innerhalb von fünf Werktagen. Gerechnet ab dem Ende am Samstag wäre der vorläufige Bericht bis Montag, 16. November, fällig, der endgültige bis Freitag, 20. November.
6. Was wir daraus lernen
Drei Erkenntnisse bleiben nach diesem Ausfall übrig: eine für die Systemarchitektur, eine für Unternehmen und eine für den eigenen Blutdruck vor dem Bildschirm.
6.1. Die Technik-Lehre: Wenn Redundanz zum Verstärker wird
Auch die größte Cloud der Welt besteht nicht aus magischen Monolithen, sondern aus unzähligen Teilen, die voneinander abhängen. Health Checks, Failover, Neuversuche und Reservekapazität fangen im Tagesgeschäft fast jeden Fehler so leise ab, dass niemand davon erfährt. In seltenen Fällen schaukeln sich genau diese Mechanismen aber gegenseitig auf. Dann wird der Schutz zum Verstärker: kein Angriff von außen, kein großer Knall, sondern kleine Dinge, die an der denkbar falschen Stelle zusammenkommen.
6.2. Für Unternehmen: Klumpenrisiko abfedern
Wer E-Mail, Kalender, Besprechungen und Dateien vollständig bei einem einzigen Anbieter bündelt, hat im Alltag viel Komfort und im Krisenfall ein ausgewachsenes Klumpenrisiko. Deshalb muss niemand sofort alles umwerfen und nostalgisch einen eigenen Mailserver in die Abstellkammer stellen. Ein pragmatischer Plan B sollte aber drei Punkte klären, bevor wieder nichts geht:
- Ein zweiter Kommunikationsweg: Ein Weg für Nachrichten, der technisch nicht am selben Anbieter hängt.
- Kontaktdaten außerhalb des Postfachs: Eine aktuelle Telefonliste, die man auch dann noch findet, wenn Exchange Online gerade streikt.
- Eine geklärte Notfallantwort: Eine klare Verabredung, was das Team konkret tut, wenn E-Mail einen Tag lang ausfällt. Beantwortet vorher, nicht hektisch währenddessen.
6.3. Für Privatnutzer: Finger weg vom Passwort-Reset
Falls bei der nächsten großen Störung dein Postfach wieder hartnäckig schweigt, hilft vor allem ein bisschen Selbstbeherrschung gegen den eigenen Aktionismus. Ich spreche aus Erfahrung, siehe Einleitung. Bei so einem Ausfall liegt es nicht an deinem Gerät. Wer reflexartig Outlook neu installiert oder hektisch sein Passwort zurücksetzt, löst kein einziges Serverproblem bei Microsoft, sondern macht sich im Zweifel nur Zusatzarbeit, wenn der Dienst längst wieder läuft. Die klügere Strategie ist unspektakulär: auf die Statusseite des Anbieters schauen und abwarten. Mein Test mit Outlook im Browser war also gar nicht so verkehrt. Die richtige Schlussfolgerung kam dann allerdings aus dem Radio.
Die E-Mails warten schließlich auch, diesmal sogar 48 Stunden lang. Und Microsoft 365 hat nächstes Jahr eine neue Chance, seinem Namen gerecht zu werden.